Mistral Large 4, Le Chonk: dove si colloca tra open weight e modelli chiusi
Mistral Large 4, alias Le Chonk, contro GLM-5.3, Kimi K3, DeepSeek V4 Pro, Claude Opus 5.5 e GPT-6 Astra: pesi, prezzi, contesto e cosa scegliere.

Mistral ha aperto la public preview di Mistral Large 4, il modello da un trilione di parametri che l'azienda chiama ufficialmente "le Chonk". È il modello più grande mai addestrato da Mistral, è nativamente multimodale e i pesi verranno rilasciati entro la fine di ottobre. Fino ad allora si usa solo via API, ed è proprio in questa finestra che serve capire meglio dove si colloca: non esiste un modello migliore in assoluto, esistono modelli che vincono su contesti diversi.
Questa rassegna mette ML4 accanto alle alternative che un team valuterebbe davvero per gli stessi carichi. Da una parte gli open weight che hanno dominato il 2026, GLM-5.3, Kimi K3 e DeepSeek V4 Pro; dall'altra i chiusi di frontiera, Claude Opus 5.5 e GPT-6 Astra; sotto, la famiglia Mistral che ML4 dovrà guidare.
Il campo, in una tabella
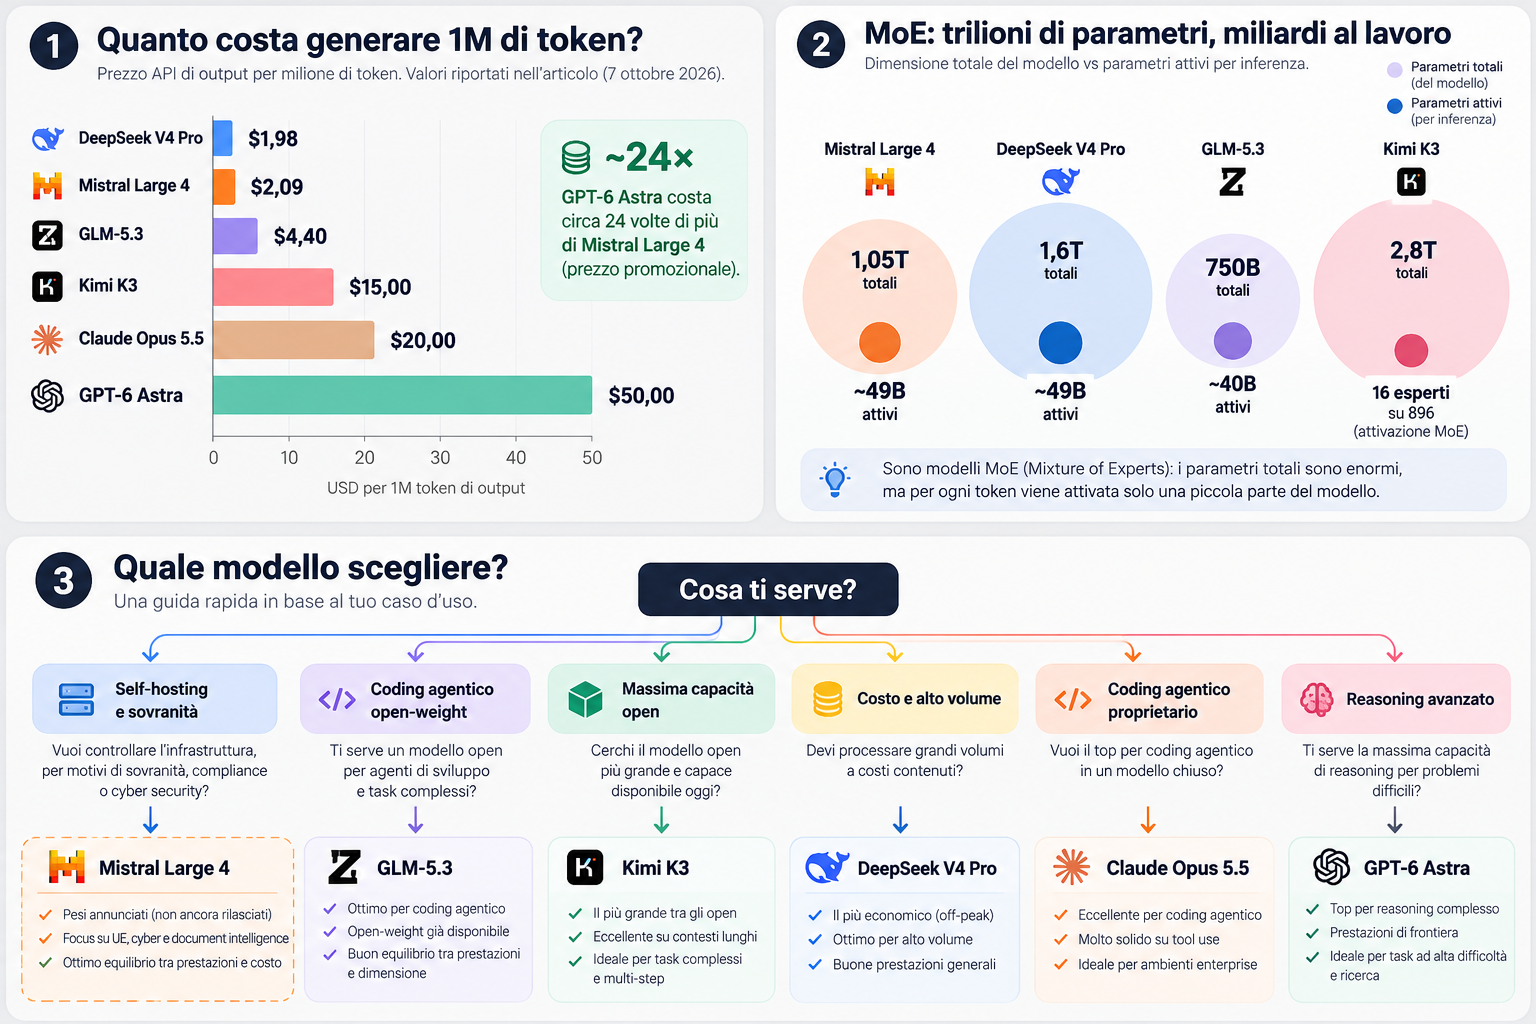
| Modello | Pesi e licenza | Architettura | Contesto | Prezzo input / output ($/M) | Input | Per chi |
|---|---|---|---|---|---|---|
| Mistral Large 4 | annunciati a fine ottobre 2026, licenza non ancora pubblicata | MoE 1,05T totali, 49B attivi* | 1M dichiarato | $0,68 / $2,09 (listino $1,36 / $4,18) | testo, immagini | sovranità dei dati in UE, cyber, document AI |
| Mistral Medium 3.5 | aperti, Modified MIT | dense 128B | 256K | $1,50 / $7,50 | testo, immagini | frontiera compatta, self-hosting su una macchina |
| GLM-5.3 | aperti a fine agosto 2026, GLM-5.3 License | MoE circa 750B, 40B attivi | 1M | $1,40 / $4,40 | testo | coding agentico, task a orizzonte lungo |
| Kimi K3 | aperti dal 27 luglio 2026, Kimi K3 License | MoE 2,8T, 16 esperti attivi su 896 | 1M | $3,00 / $15,00 | testo, immagini, video | massima capacità tra gli open weight |
| DeepSeek V4 Pro | aperti, licenza MIT | MoE 1,6T, 49B attivi | 1M | $0,66 / $1,98 (off-peak) | testo | prezzo off-peak, codice, alto volume |
| Claude Opus 5.5 | proprietari, chiusi | non dichiarata | 1M | $4,00 / $20,00 | testo, immagini | coding e agenti di frontiera |
| GPT-6 Astra | proprietari, chiusi | non dichiarata | 1,05M | $10,00 / $50,00 | testo, immagini | reasoning e lavoro end-to-end |
Tre avvertenze sulla tabella. La prima è sui parametri di ML4: l'annuncio di Mistral parla di 49 miliardi di parametri attivi, mentre la pagina del modello ne indica 52. È una discrepanza nella documentazione dello stesso modello, non due modelli diversi, e va letta come tale.
La seconda è sui prezzi di ML4, che sono quelli in sconto: la pagina pricing di Mistral mostra le tariffe di listino ($1,36 in input, $4,18 in output) barrate e affiancate da quelle promozionali ($0,68 e $2,09), senza dire se lo sconto sia di anteprima o definitivo.
La terza è sui prezzi di DeepSeek V4 Pro, ufficiali ma elastici: l'API DeepSeek li dimezza nelle ore off-peak, quindi $0,66 e $1,98 valgono fuori dalle fasce di punta e salgono a $1,32 e $3,96 nelle ore piene.
Il contesto merita una riga a parte, perché in tabella convivono due cose diverse. ML4 dichiara un milione di token nella model card, ma gli endpoint di terze parti ne servono circa la metà: su OpenRouter mistral-large-4-0 espone 524.288. Chi dimensiona una pipeline sull'1M della scheda deve verificare il limite reale del fornitore che usa, non quello del modello.
Gli open weight con cui si misura
GLM-5.3, il rivale diretto sul codice
GLM-5.3 è il modello con cui ML4 si confronta più spesso, perché entrambi puntano a coding e agenti. Z.ai lo ha presentato e poi pubblicato in open weight a fine agosto, con una licenza MIT-like che chiede una revisione di sicurezza a Z.ai solo per chi supera i 10 miliardi di dollari di ricavi annui. È un MoE da circa 750 miliardi di parametri totali e 40 attivi, con un contesto da 1.048.576 token e una pagina di documentazione che dichiara il solo input testuale.
Sul piano del prezzo è il più vicino a ML4: $1,40 in input e $4,40 in output, un po' sotto le tariffe di listino di Le Chonk e sopra quelle promozionali. Sul codice, Z.ai rivendica un miglioramento del 50% rispetto a GLM-5.2 e lo stato di artefatto open weight più forte su Terminal Bench 3.0. È la scelta quando il carico è agentico, testuale e ripetuto, e non serve la visione.
Kimi K3, il tetto degli open weight
Kimi K3 è il modello più grande con pesi aperti mai pubblicato: 2,8 trilioni di parametri, di cui 16 esperti attivi su 896, un contesto dichiarato di un milione di token e input di testo, immagini e video. Moonshot lo ha annunciato a luglio e ha rilasciato i pesi il 27 luglio 2026 sotto la Kimi K3 License, una licenza personalizzata che non è né MIT né Apache e che chiede un accordo separato a chi rivende il modello come servizio oltre certe soglie di ricavo.
A $3,00 in input e $15,00 in output è il più caro del gruppo open, e il divario non è piccolo: costa più del doppio di GLM-5.3 e diverse volte ML4 in sconto. In cambio offre la capacità più alta della fascia aperta sul lavoro intellettuale e sulle sessioni di coding lunghe. È la voce da scegliere quando il tetto di qualità conta più della bolletta, e quando si è letto la licenza prima di costruirci un prodotto.
DeepSeek V4 Pro, due modelli in uno
DeepSeek gioca una partita diversa: i pesi sono MIT e il prezzo ufficiale, letto sulla pagina API, parte da $0,66 in input e $1,98 in output nelle ore off-peak, con cache hit a $0,022. È un MoE da 1,6 trilioni di parametri e 49 miliardi attivi nella preview, saliti a 1,7 trilioni nel checkpoint 0813 che l'API serve oggi, con contesto da un milione di token.
La vera leva di prezzo, però, non è V4 Pro: nella stessa pagina DeepSeek tiene un fratello più leggero ed economico, DeepSeek V4.1 Flash, che scende a $0,15 e $0,60 nelle ore off-peak e in più accetta immagini. V4 Pro, in confronto a ML4, non è affatto il più economico: in off-peak è in parità con le tariffe promozionali di Le Chonk, e in peak è più caro, $1,32 e $3,96 contro $0,68 e $2,09. Il costo minimo del confronto ha un altro nome, ed è V4.1 Flash.
Il compromesso è la collocazione. DeepSeek è tra i più convenienti per volume e il codice è la sua specialità, ma è anche il modello su cui le organizzazioni con requisiti di conformità europei o statunitensi pongono più domande prima di adottarlo.
I modelli chiusi di frontiera
Claude Opus 5.5
Anthropic posiziona Opus 5.5 per il coding agentico e il lavoro aziendale quotidiano, con contesto fino a un milione di token e prezzi ufficiali di $4,00 in input e $20,00 in output. È il modello che Mistral stessa usa come termine di paragone: nella valutazione umana sul codice condotta con Surge AI, Claude Opus 5 è l'unico davanti a ML4, con 4,22 contro 3,74.
Il punto in cui i due si separano non è il punteggio, è il comportamento sui compiti di sicurezza. Mistral dichiara che Claude Opus 5.5 si ferma vicino allo zero sul test che chiede di riprodurre una vulnerabilità reale, perché il filtro di sicurezza rifiuta il compito. Per chi difende software, un rifiuto a metà incidente è un rischio a sua volta.
GPT-6 Astra
GPT-6 Astra è il riferimento sul reasoning: contesto da 1,05 milioni di token e prezzo, secondo il listino API di OpenAI, di $10,00 in input e $50,00 in output sotto i 272.000 token, che salgono a $20,00 e $75,00 sopra quella soglia. È il modello più caro della tabella, circa due volte e mezzo Opus 5.5 a parità di token e oltre dieci volte ML4 in sconto, ed è la voce da considerare quando il compito è un ragionamento lungo che nessun open weight chiude.
Sulla visione, Mistral rivendica un sorpasso stretto: sul test Dense 200 di visual grounding, ML4 segna 42% contro il 41% di GPT-6 Astra. È un margine di un punto, non una gerarchia, e vale per quel benchmark.
La famiglia Mistral sotto ML4
ML4 non è un pezzo isolato: Mistral lo descrive come la base per una nuova generazione di modelli specializzati, e la famiglia che erediterà quel lavoro esiste già. Il listino ufficiale mette in fila Mistral Large 3 a $0,50 e $1,50, Mistral Medium 3.5 a $1,50 e $7,50 con pesi aperti sotto Modified MIT e 128 miliardi di parametri dense, Mistral Small 4 a $0,15 e $0,60, i Ministral 3 da 3B, 8B e 14B tra $0,10 e $0,20, Codestral a $0,30 e $0,90 per il codice e OCR 4.1 a $4 ogni mille pagine.
Per chi oggi ha bisogno di pesi aperti e non può aspettare fine ottobre, la via non è ML4 ma Medium 3.5: è l'unico modello di fascia alta della casa già scaricabile, con licenza permissiva e un contesto da 256K. Il confronto tra i due è anche il modo più onesto di leggere il salto: ML4 promette un trilione di parametri e un milione di contesto, Medium 3.5 consegna 128 miliardi e 256K, ma consegna.
Cosa scegliere, per contesto
- Dati che non possono uscire dall'Unione europea: ML4, quando i pesi saranno fuori. È l'unico del confronto addestrato da zero su 3.800 GPU Grace Blackwell nei datacenter europei di Mistral, con un deployment europeo gestito end-to-end. Oggi, senza pesi, la scelta ricade sull'API Mistral nell'area europea o su Medium 3.5 in self-hosting.
- Sicurezza difensiva e ricerca sulle vulnerabilità: ML4, per il 82% sul test che riproduce e corregge una vulnerabilità reale, il punteggio più alto misurato, e per il 93% su Cybench. Il valore non è solo il numero: è che i chiusi di frontiera rifiutano lo stesso compito.
- Document intelligence, visione e grounding: ML4 se il documento è un'immagine densa, un disegno tecnico o una mappa; Claude Opus 5.5 o GPT-6 Astra se al documento serve associare un ragionamento più forte e il costo non è il vincolo.
- Coding agentico open weight a costo contenuto: GLM-5.3, che a $1,40 e $4,40 con 1M di contesto è il rivale più diretto e non ha i gate commerciali di Kimi K3. Per volumi molto alti, DeepSeek V4.1 Flash è il più economico del confronto; V4 Pro, in off-peak, è in parità con ML4 in sconto.
- Massima capacità tra i pesi aperti: Kimi K3, al prezzo più alto della fascia aperta. È la scelta quando il tetto di qualità conta più del costo per token.
- Frontiera chiusa e lavoro end-to-end: Claude Opus 5.5 per il coding agentico, GPT-6 Astra per il reasoning più difficile. Entrambi costano diverse volte ML4 e non si possono self-hostare.
- Budget minimo o prototipo: DeepSeek V4.1 Flash, Mistral Small 4 o i Ministral 3, tutti sotto il dollaro per milione di token in output.
Un vincitore assoluto non c'è. ML4 vince dove servono autonomia europea, cyber e multimodalità; GLM-5.3 e DeepSeek vincono sul rapporto tra costo e codice; Kimi K3 sul tetto di capacità aperta; i chiusi sul reasoning e sul coding di frontiera. La scelta dipende da quale di queste dimensioni è il vincolo del proprio carico.
Cosa guardare prima di decidere
Tre cose della tabella invecchiano in fretta e vanno ricontrollate.
La seconda è che il contesto dichiarato non è il contesto servito. Vale per ML4 come per gli altri: la cifra che conta è quella che l'endpoint espone, non quella della model card.
La terza è che il prezzo per token non è il costo per task. ML4 è economico per token ma viene descritto come verboso, e in un loop agentico la verbosità moltiplica la spesa. Kimi K3, all'opposto, costa $15 ogni milione di token in output: sette volte ML4 in sconto. Prima di firmare una scelta, conviene rifare il conto sul proprio carico reale, con il rapporto tra input e output che si usa davvero.
Fonti
- Introducing Mistral Large 4 (annuncio Mistral del 6 ottobre 2026: architettura, cyber, coding, multimodalità, sovranità europea, roadmap dei pesi)
- Mistral Large 4, model card e documentazione (parametri, contesto, versioning
openv26.10) - Mistral, pagina pricing (tariffe di ML4, Medium 3.5, Small 4, Ministral 3, Codestral, OCR 4.1)
- Mistral Medium 3.5 su Hugging Face (pesi aperti e licenza Modified MIT)
- Z.ai, GLM-5.3 (annuncio e benchmark di coding, licenza e rilascio dei pesi)
- GLM-5.3, documentazione Z.ai (contesto 1M, input testuale, output massimo)
- GLM-5.3 su Hugging Face (pesi e GLM-5.3 License)
- Kimi K3 su Hugging Face (2,8T parametri, pesi e Kimi K3 License)
- DeepSeek, Models & Pricing (V4 Pro e V4.1 Flash: contesto 1M, prezzi off-peak e peak)
- DeepSeek-V4-Pro su Hugging Face (licenza MIT, 1,6T e 49B attivi nella preview, 1,7T nel checkpoint 0813)
- Anthropic, pagina pricing (Claude Opus 5.5: $4 / $20, contesto fino a 1M)
- OpenAI, API pricing (GPT-6 Astra: $10 / $50 sotto 272K, $20 / $75 sopra)
- Mistral Large 4 su OpenRouter (contesto servito dagli endpoint: 524.288)

